Sommaire
La pollution IA se mesure, et ses ordres de grandeur surprennent dans les deux sens. Selon le calcul de l'équipe Data de Carbo, une simple requête textuelle à un assistant comme ChatGPT, Claude ou Gemini émet environ 0,12 g CO2e, un peu moins qu'un email. Le CO2e, ou équivalent CO2, est l'unité qui additionne tous les gaz à effet de serre selon leur effet sur le climat.
L'écart se creuse vite avec la longueur des conversations : une conversation de 30 échanges (1 échange = 1 question + 1 réponse) émet environ 7 g CO2e, 16 fois plus qu'une conversation de 3 échanges, et une vidéo générée de 5 secondes plus de 40 g.
La pollution IA ne se résume pas au carbone : l'IA pèse aussi sur l'eau, les ressources minérales et les territoires, et soulève des enjeux de société plus largement. Cet article se concentre sur le carbone après un bref aperçu des autres impacts environnementaux. L'objectif : vous donner des ordres de grandeurs et équivalents pour prendre la mesure de votre usage.
Requête, raisonnement, image, vidéo, présentation, rapport, recherche approfondie et agents IA sont chiffrés ci-dessous, puis comparés à des repères familiers, de l'email au kilomètre en voiture thermique.
De quoi parle-t-on quand on parle de pollution IA ?
La pollution IA désigne ici les émissions de gaz à effet de serre liées à l'IA générative, celle qui produit du texte, des images ou des actions à partir d'une consigne. Dans le langage courant, « IA » renvoie surtout aux LLM (Large Language Models, ou grands modèles de langage) : des modèles entraînés sur d'immenses volumes de texte pour prédire la suite la plus probable d'une phrase.
Les programmes conversationnels ne datent pas d'hier : ELIZA simulait déjà un dialogue en 1966. Les LLM n'apparaissent en revanche qu'à la fin des années 2010, après la publication en 2017 de l'architecture Transformer, qui leur permet de traiter de très grands volumes de texte. La génération d'images repose souvent sur une autre famille, les modèles de diffusion, mais obéit à la même logique : chaque résultat demande du calcul sur des serveurs spécialisés.
Trois notions reviennent dans la suite de l'article.
- Le modèle d'IA est l'algorithme entraîné qui génère la réponse, par exemple GPT-5.5, Claude Sonnet 4.6 ou Gemini 3.1 Pro.
- Le fournisseur est l'organisme qui y donne accès : OpenAI, Anthropic, Google ou Mistral AI.
- Le prompt est le texte écrit par l'utilisateur pour poser une question ou donner une consigne.
Les autres termes sont définis dans le lexique en fin d'article, et les pistes pour rendre l'IA plus sobre sont détaillées dans l'article sur le green AI.
Quels sont les impacts environnementaux de l'IA au-delà du carbone ?
Comme l'ensemble de la pollution numérique, la pollution IA dépasse les émissions de gaz à effet de serre, bien entendu. Parmi les impacts environnementaux, on compte :
- L'eau. Les data centers ont besoin de grandes quantités d'eau pour refroidir leurs équipements, et la production de l'électricité qu'ils consomment en mobilise aussi. La consommation d'eau de ChatGPT et des autres assistants dépend fortement du site, de son climat et de son système de refroidissement.
- Les métaux. Les puces qui font tourner l'IA reposent sur une fabrication de semi-conducteurs gourmande en minerais, qui produit aussi des sous-produits chimiques dangereux pour l'air et l'eau, selon Amnesty International.
- Les déchets électroniques. Les serveurs et les GPU des data centers sont renouvelés tous les deux à cinq ans, au rythme des nouvelles générations de puces. Une étude publiée dans Nature Computational Science en 2024 conclut que la croissance de l'IA générative aggraverait un problème de déchets électroniques déjà préoccupant.
Pourquoi l'IA émet-elle des gaz à effet de serre ?
L'IA émet des gaz à effet de serre parce que chaque réponse est calculée par des processeurs graphiques (GPU) installés dans des data centers. Ces puces consomment de l'électricité, et leur fabrication a elle-même une empreinte. Trois sources d'émissions s'additionnent.
- L'électricité de l'inférence. Chaque réponse, appelée inférence, fait tourner des puces qui consomment de l'électricité, et le data center en consomme à nouveau pour se refroidir, un enjeu détaillé dans l'article sur la pollution des data centers. Les émissions dépendent du mix électrique du pays où se trouve le serveur.
- La fabrication du matériel. L'empreinte de fabrication d'une puce se répartit sur sa durée de vie.
- L'entraînement du modèle. Avant d'être utilisable, un modèle est entraîné une fois par un calcul massif. Les émissions de CO2e, bien que ponctuelles, sont dans les calculs réparties ensuite sur toutes les requêtes que le modèle servira pendant sa vie.
Dans les faits, l'empreinte d'un usage dépend avant tout de la quantité d'éléments que le modèle doit lire et produire. Plus le résultat est long à produire, plus il demande de calcul.
Dans une même conversation, à chaque nouvelle question, le modèle relit toute la conversation depuis le début. Plus une conversation s'allonge, plus chaque réponse pollue. C'est ce mécanisme qui explique les écarts chiffrés plus bas.
Combien émet une requête, une conversation, une image ou un agent IA ?
Selon le calcul Carbo, les usages de l'IA vont d'un dixième de gramme à plusieurs dizaines de grammes de CO2e. Deux facteurs font la différence : le type de contenu produit, l'image et surtout la vidéo demandant bien plus de calcul que le texte, et le volume d'informations que le modèle doit lire et produire.
| Usage | Émissions (g CO2e) | Fourchette selon le modèle utilisé (g CO2e) | Équivalent en distance parcourue voiture thermique |
|---|---|---|---|
| Requête textuelle (une question/réponse) | ≈ 0,12 | 0,04 à 0,37 | 0,8 m |
| Conversation courte (3 échanges) | ≈ 0,46 | 0,15 à 1,4 | 3 m |
| Génération d'une image | ≈ 0,7 | 0,2 à 1,2 | 5 m |
| Requête avec raisonnement | ≈ 1,5 | 0,3 à 3,1 | 11 m |
| Conversation moyenne (10 échanges) | ≈ 1,8 | 0,6 à 5,9 | 13 m |
| Conversation longue (30 échanges) | ≈ 7,4 | 2,4 à 24 | 52 m |
| Génération d'une présentation de 10 diapositives | ≈ 8,6 | 2,5 à 18 | 60 m |
| Tâche d'un agent IA (20 étapes dans un navigateur) | ≈ 11 | 2 à 25 | 80 m |
| Production d'un rapport PDF de 10 pages | ≈ 12,5 | 3,7 à 27 | 90 m |
| Recherche approfondie (Deep Research) | ≈ 21 | 3,2 à 46 | 150 m |
| Tâche d'un agent de code (25 étapes) | ≈ 23 | 4,2 à 52 | 165 m |
| Vidéo IA de 5 secondes (720p) | ≈ 44 | 12 à 170 | 310 m |
Source : note méthodologique de l'équipe Data de Carbo (PDF téléchargeable), novembre 2026. Valeur centrale pondérée par les modèles réellement utilisés en 2026 pour chaque usage ; fourchette entre le modèle le plus sobre et le plus émetteur de ce mix. Requêtes et conversations sans mode raisonnement, sauf mention contraire. Voiture thermique : 142 g CO2e/km, d'après la Base Empreinte de l'ADEME.
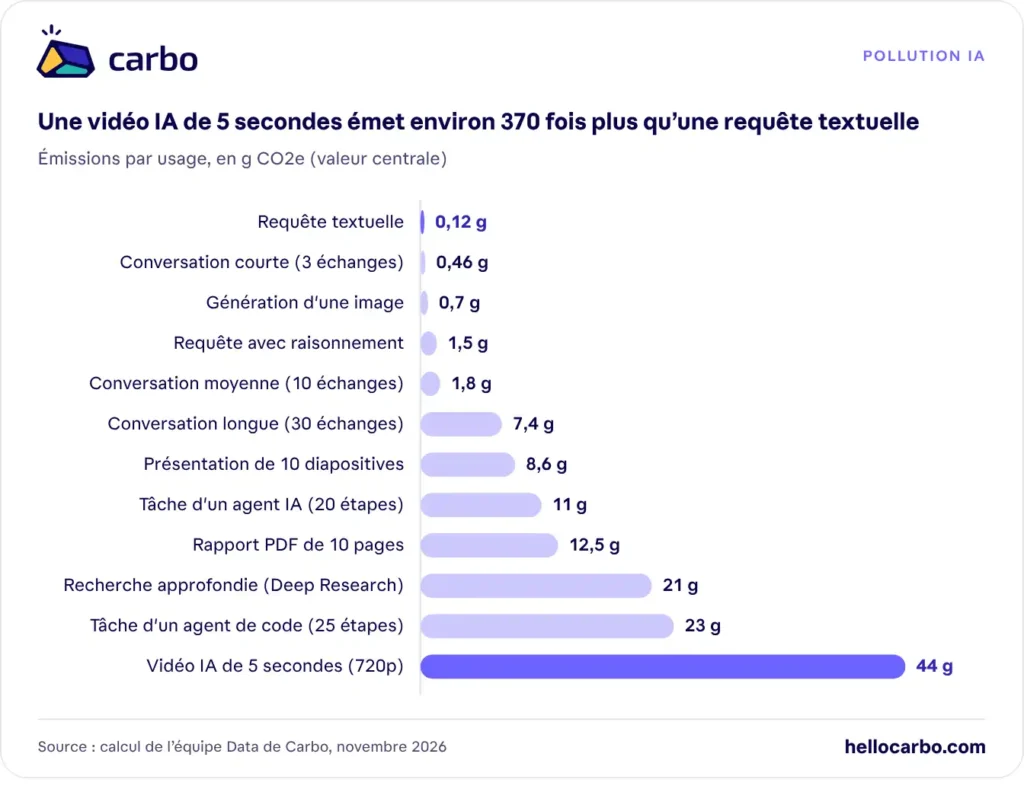
Une conversation coûte plus cher à chaque échange. Le modèle relit tout l'historique avant chaque réponse, même si les fournisseurs gardent ce texte en mémoire (en cache) pour en réduire le coût. Passer de 3 à 30 échanges multiplie certes leur nombre par 10, mais les émissions sont, elles, multipliées par 16 !
Un agent IA démultiplie la lecture. Un agent est une IA qui agit dans un environnement, un navigateur par exemple, au lieu de seulement répondre. Pour réserver un billet de train, il enchaîne une vingtaine d'étapes et relit à chacune son contexte complet, captures d'écran comprises. Une seule tâche émet autant que près de 100 requêtes textuelles.
Présentation et rapport suivent la même logique. Le calcul suppose un assistant qui lit des documents sources, écrit le fichier et le vérifie en plusieurs passes. Une présentation de 10 diapositives ou un rapport de 10 pages pèsent alors environ 9 à 13 g CO2e, l'équivalent de 60 à 90 m en voiture.
Raisonnement, recherche et code multiplient la production. En mode raisonnement, le modèle rédige environ 3 300 tokens de réflexion invisible avant de répondre : la requête émet alors environ 13 fois plus qu'une requête classique. Une recherche approfondie (Deep Research) ou une tâche d'agent de code, qui enchaînent des dizaines d'étapes de lecture et d'écriture, dépassent 20 g CO2e.
L'image et surtout la vidéo pèsent plus lourd que le texte. Une image émet environ 6 fois plus qu'une requête textuelle. Une vidéo de 5 secondes émet environ 44 g CO2e, autant qu'environ 370 requêtes : c'est l'usage le plus émetteur du tableau.
Le choix du modèle compte. Pour une même tâche, l'écart entre le modèle le plus sobre et le plus émetteur du calcul va de 1 à 10 environ : c'est ce que montre la fourchette du tableau. Les modèles légers, utilisés par défaut dans les versions gratuites des assistants, sont nettement plus sobres que les modèles les plus puissants.
Des estimations confrontées aux chiffres publiés. Le calcul Carbo retient 0,29 Wh d'électricité pour une requête textuelle : environ 0,25 Wh pour les serveurs, plus la consommation du data center qui les héberge, notamment pour le refroidissement. Google annonce 0,24 Wh pour une requête texte médiane sur Gemini, et Epoch AI estime 0,3 Wh pour une requête ChatGPT typique. Le détail de cette vérification figure dans l'encadré méthode ci-dessous.
| Référence | Émissions | Équivaut à combien de conversations courtes de 3 échanges (≈ 0,46 g CO2e) ? | 1 rapport PDF de 10 pages généré par l'IA (≈ 12,5 g CO2e) équivaut à… |
|---|---|---|---|
| 0,17 g CO2e | 1 email ≈ 0,4 conversation | 1 rapport PDF ≈ 75 emails | |
| Ampoule LED (12 W) | 0,7 g CO2e | 1 h d'ampoule ≈ 1,5 conversation | 1 rapport PDF ≈ 18 h d'ampoule |
| Cycle de lave-linge à 30 °C | 28,5 g CO2e | 1 cycle ≈ 62 conversations | 1 rapport PDF ≈ 0,4 cycle |
| Streaming vidéo | 31,3 g CO2e | 1 h de streaming ≈ 68 conversations | 1 rapport PDF ≈ 24 min de streaming |
| Voiture thermique | 142 g CO2e | 1 km ≈ 310 conversations | 1 rapport PDF ≈ 90 m |
| Repas végétarien | 510 g CO2e | 1 repas ≈ 1 100 conversations | 1 rapport PDF ≈ 2,5 % d'un repas |
L'ampoule et le lave-linge sont convertis en CO2e avec le facteur de l'électricité française, 0,057 kg CO2e/kWh. Le calcul IA retient, lui, en moyenne 0,375 kg CO2e/kWh, détaillé dans l'encadré méthode.
Sources : Base Empreinte de l'ADEME pour l'email, la voiture et le streaming, hors fabrication des terminaux pour ce dernier ; ADEME, Base Carbone v21.0 pour le repas végétarien ; ADEME, guide « Réduire sa facture d'électricité » (2016) pour l'ampoule ; mémo ADEME-CNFPT (2016) pour le lave-linge ; Base Empreinte de l'ADEME pour l'électricité française.
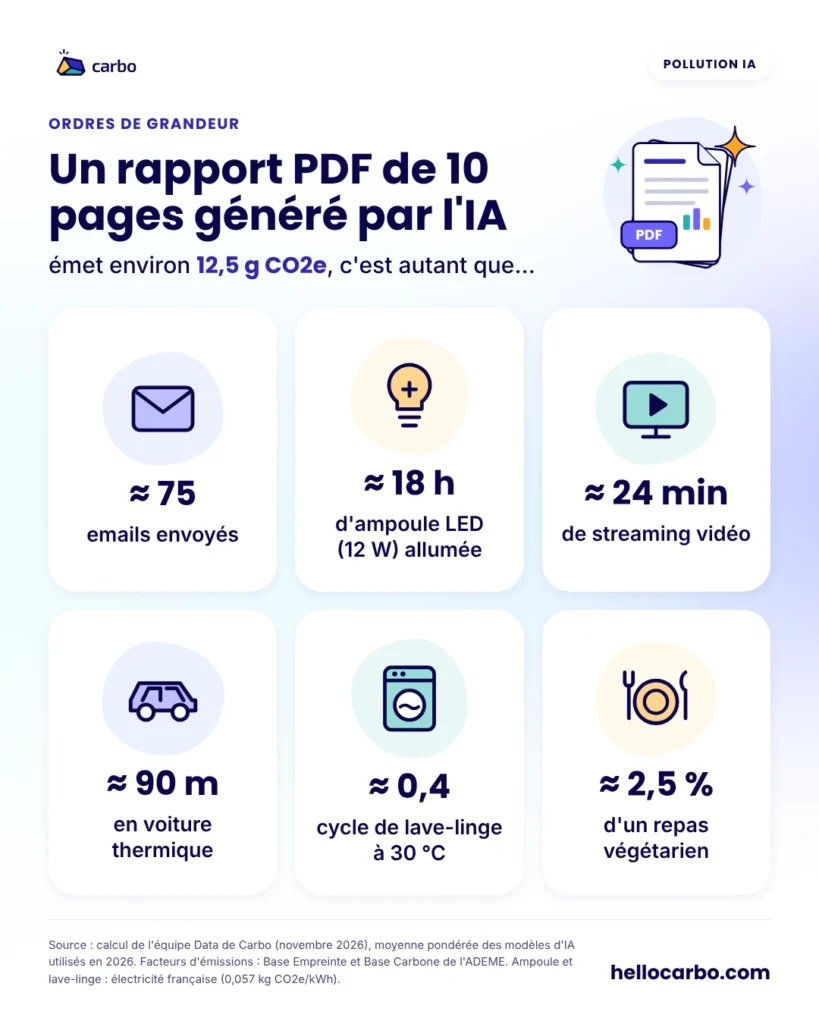
Sur des usages plus lourds, les équivalences deviennent parlantes : une vidéo IA de 5 secondes correspond à environ 1 h 25 de streaming vidéo ou 310 m en voiture, et une tâche d'agent de code à 45 minutes de streaming.
Ces comparaisons ne portent pas exactement sur le même périmètre. Les chiffres de l'IA couvrent le data center, alors que le streaming pèse surtout sur le réseau qui transporte la vidéo : 27,8 g sur les 31,3 g d'une heure de streaming.
Faible à l'unité, l'IA pèse par le volume. Une requête qui équivaut à moins d'un mètre en voiture ne dit pas grand-chose de l'impact global de l'IA. Celui-ci dépend du nombre de requêtes, qui augmente vite : l'IA s'intègre par défaut aux moteurs de recherche, aux messageries et aux logiciels du quotidien, souvent sans que l'utilisateur l'ait demandé, et les agents enchaînent des dizaines d'étapes à chaque tâche. C'est l'effet rebond, aussi appelé paradoxe de Jevons : les modèles deviennent plus efficaces, mais la hausse des usages absorbe, voire dépasse, les gains obtenus sur chaque requête. Localement, la concentration des data centers met déjà sous tension certains réseaux électriques, comme en Irlande ou en Virginie, selon l'Ifri.
L'IA pèse-t-elle lourd dans l'empreinte carbone d'un salarié ?
Tout dépend de ses usages. Quelques requêtes textuelles par jour pèsent peu, mais la généralisation des agents peut changer cet ordre de grandeur : une seule de leurs tâches émet autant que près de 100 requêtes textuelles, tout comme la génération de vidéo. Suivre ce poste dès maintenant permet d'arbitrer avant qu'il ne prenne de l'ampleur.
Comment une organisation peut-elle limiter la pollution IA ?
Une organisation limite la pollution IA en encadrant les usages plutôt qu'en les interdisant, et le point de départ est la mesure.
- Mesurer avant d'arbitrer. Intégrer l'usage de l'IA au bilan carbone situe ce poste face aux autres, et permet d'y consacrer un effort adapté, ou de se concentrer sur d'autres postes en priorité si besoin.
- Référencer un outil. Un outil unique, configuré avec un modèle par défaut adapté aux usages courants, évite que chaque salarié recoure au modèle le plus puissant pour des tâches simples.
- Fixer des limites de consommation. Des quotas de tokens par équipe ou par usage rendent la consommation visible et pilotable.
- Rédiger une charte d'usage. Elle précise les usages encouragés, ceux à éviter et l'encadrement des agents, dont chaque tâche pèse lourd. Elle s'inscrit dans une démarche de numérique responsable.
- Former les équipes. Les ordres de grandeur de cet article suffisent à faire comprendre pourquoi une nouvelle conversation ou un modèle plus léger changent le résultat. Le toolkit sur l'empreinte carbone des usages numériques peut servir de support.
Comment limiter la pollution IA à titre individuel ?
À titre individuel, limiter la pollution IA tient à quelques réflexes, tirés directement des mécanismes décrits plus haut. Ils rejoignent les principes de la sobriété numérique.
- Se demander si l'IA apporte un gain. Une recherche simple, une réponse déjà connue ou un calcul rapide se passent souvent d'un assistant.
- Ouvrir une nouvelle conversation pour chaque sujet. Le modèle relit tout l'historique à chaque question : 30 échanges émettent 16 fois plus que 3.
- Ne garder dans le contexte que l'utile. Documents collés, mémoire activée, outils connectés : tout ce qui entre dans le contexte est relu à chaque échange.
- Choisir un modèle adapté à la tâche. Pour un même usage, l'écart entre modèles va de 1 à 10 environ, et un modèle léger suffit souvent pour reformuler ou résumer.
- Réserver les agents aux tâches qui le justifient. Une tâche d'agent émet autant que près de 100 requêtes textuelles.
- Réserver le raisonnement et la vidéo aux besoins réels. Le mode raisonnement multiplie l'empreinte d'une requête par 13 environ, et une vidéo de 5 secondes émet autant qu'environ 370 requêtes.
Le CO2e n'est qu'une partie du sujet. Ces réflexes réduisent les émissions de gaz à effet de serre, seul impact chiffré dans cet article. L'IA consomme aussi de l'eau et des métaux, produit des déchets électroniques et pèse sur les réseaux électriques locaux : autant d'impacts environnementaux qu'un équivalent CO2e ne traduit pas. Elle soulève aussi des questions sociales, comme les conditions de travail des personnes qui annotent les données servant à entraîner les modèles. Éviter les usages superflus reste le levier qui agit sur tous ces impacts à la fois.
L'usage de l'IA est-il l'activité qui émet le plus de CO2e dans votre entreprise ? Pour répondre à cette question, réalisez votre bilan carbone.
Bouton : Prendre RDV avec un expert Carbo
Lexique
- Modèle d'IA : l'algorithme entraîné sur des données qu'un fournisseur d'IA utilise pour générer les réponses. Exemples : GPT-5.5, Claude Sonnet 4.6, Gemini 3.1 Pro.
- Fournisseur : l'organisme qui donne accès à un modèle d'IA. Exemples : Anthropic, OpenAI, Google, Mistral AI.
- Prompt : le texte écrit par l'utilisateur pour donner des consignes ou poser des questions à l'IA.
- Token : le fragment de mot dans lequel un modèle découpe le texte qu'il lit et écrit, soit environ trois quarts de mot en anglais.
- Inférence : le moment où le modèle produit une réponse, par opposition à son entraînement.
- Agent ou IA agentique : une IA qui prend des actions concrètes dans un environnement, comme réserver des billets de train, prendre des rendez-vous dans un agenda ou répondre à des emails en autonomie. Un chatbot classique, lui, répond à un prompt par du texte ou une image.
- Recherche approfondie (Deep Research) : un mode où l'assistant mène lui-même une recherche en plusieurs étapes, en consultant et en lisant de nombreuses sources sur le web, puis rédige une synthèse argumentée et sourcée.
- CO2e (équivalent CO2) : l'unité qui additionne tous les gaz à effet de serre en les convertissant en la quantité de CO2 qui aurait le même effet sur le réchauffement.
- Scope 2 et scope 3 : deux catégories du bilan carbone. Le scope 2 regroupe les émissions liées à l'énergie achetée par l'entreprise, comme l'électricité ; le scope 3, les autres émissions indirectes, dont celles des services achetés.
- Mix électrique : la répartition des sources (nucléaire, renouvelables, gaz, charbon…) qui produisent l'électricité d'un pays. Il détermine les émissions de chaque kWh consommé.
- Modèle de diffusion : la famille de modèles la plus utilisée pour générer des images. Il part d'un bruit aléatoire et l'affine étape par étape jusqu'à obtenir l'image demandée.
- Contexte et cache : le contexte est tout le texte que le modèle relit avant de répondre (historique de la conversation, documents, instructions). Le cache conserve une partie de ce texte déjà traité pour ne pas tout recalculer, ce qui réduit l'énergie nécessaire.
FAQ
Selon le calcul de l'équipe Data de Carbo, une requête textuelle à un assistant comme ChatGPT émet environ 0,12 g CO2e, entre 0,04 et 0,37 g selon le modèle utilisé, soit un peu moins qu'un email. Ce résultat est cohérent avec les chiffres publiés par les fournisseurs, comme Google pour Gemini. En mode raisonnement, la même requête émet environ 1,5 g.
Les data centers utilisent de l'eau pour se refroidir, et la production de leur électricité en consomme aussi. Le volume dépend fortement du site, de son climat et de son système de refroidissement. Ce poste n'est pas couvert par le calcul Carbo présenté ici, qui porte sur les émissions de gaz à effet de serre.
Les deux comptent. L'entraînement est une dépense ponctuelle, répartie sur toutes les requêtes servies pendant la vie du modèle ; l'utilisation se répète à chaque requête. Leur répartition dépend du nombre de requêtes qu'un modèle traite sur sa durée de vie, que les fournisseurs ne publient pas. Le calcul Carbo intègre les deux.
Quand elle passe par des services en ligne comme ChatGPT, Claude ou Gemini, l'IA relève en général du scope 3 du bilan carbone, au titre des services achetés. Si l'entreprise fait tourner ses propres modèles sur ses serveurs, l'électricité consommée relève du scope 2. Son poids varie fortement d'une entreprise à l'autre, selon les outils utilisés, le nombre d'utilisateurs et le recours aux agents IA. Seule une mesure propre à l'organisation permet de le situer face aux autres postes de son bilan carbone d'entreprise. Dans l'offre de bilan carbone Carbo Entreprise, l'usage de l'IA est intégré aux questionnaires employés.
Sources
- Carbo, équipe Data, note méthodologique « Empreinte carbone des usages de l'IA », novembre 2026 (PDF téléchargeable)
- ML.ENERGY Leaderboard v3.0, janvier 2026 : énergie du raisonnement et de la génération d'images
- Similarweb (août-septembre 2026) et Comscore (T2 2026) : parts d'audience des assistants IA, reprises dans le calcul Carbo
- Ifri, Laure de Roucy-Rochegonde et Adrien Buffard, « IA, centres de données et énergie. Quelles tendances ? », février 2025 : eau, réseaux électriques, Irlande, Virginie